认识--大数据
一、大数据介绍
学习目标
-
-
能够了解大数据指的是什么
为什么使用大数据技术?
-
数据量越来越大
-
数据分析的实时性越来越强
-
数据结果的应用越来越广泛
大数据的定义
大数据是收集、整理、处理大容量数据集,并从中获得结果的技术总称。
二、大数据应用领域
学习目标 能够了解大数据应用在哪些领域
-
广告 广告投放 广告策略
-
电信 深度包检测 流失分析 网络质量
-
金融 风险识别 预测
-
能源生物 基因组分析 地质分析
-
安全 入侵检测 图像识别
-
社交游戏 流失分析 社交推荐 使用分析
-
电商零售 推荐系统 交易分析
三、大数据技术处理框架有哪些?
什么是大数据处理框架?
处理框架和处理引擎负责对数据系统中的数据进行计算。 虽然“引擎”和“框架”之间的区别没有什么权威的定义,但大部分时候可以将前者定义为实际负责处理数据操作的组件,后者则可定义为承担类似作用的一系列组件。
大数据处理框架有哪些?
仅批处理框架 用于批量处理大数据集的处理框架,可对整个数据集进行操作。 例如: Apache Hadoop,一种以MapReduce作为默认处理引擎批处理框架。
仅流处理框架 用于对随时进入系统的数据进行计算,是一种“无数据边界”的操作方式。 例如: Apache Storm Apache Samza
混合处理框架 一些大数据处理框架可同时处理批处理和流处理工作负载。 例如: Apache Spark Apache Flink
总结:
-
处理框架 一组组件
-
处理引擎 具体对数据操作的工具
-
框架分类
-
仅批处理框架 apache hadoop MapReduce
-
仅流处理框架 apache storm apache samza
-
混合处理框架 apache spark apache flink
-
四、hadoop生态圈
Hadoop历史
雏形开始于2002年的Apache的Nutch,Nutch是一个开源Java 实现的搜索引擎。它提供了我们运行自己的搜索引擎所需的全部工具。包括全文搜索和Web爬虫。
随后在2003年Google发表了一篇技术学术论文谷歌文件系统(GFS)。GFS也就是google File System,google公司为了存储海量搜索数据而设计的专用文件系统。
2004年Nutch创始人Doug Cutting基于Google的GFS论文实现了分布式文件存储系统名为NDFS。2004年Google又发表了一篇技术学术论文MapReduce。MapReduce是一种编程模型,用于大规模数据集(大于1TB)的并行分析运算。
2005年Doug Cutting又基于MapReduce,在Nutch搜索引擎实现了该功能。
2006年,Yahoo雇用了Doug Cutting,Doug Cutting将NDFS和MapReduce升级命名为Hadoop,Yahoo开建了一个独立的团队给Goug Cutting专门研究发展Hadoop。
总结:
-
NDFS--->HDFS
-
MapReduce
项目定义
-
Apache™Hadoop®项目用于可靠,可扩展的分布式计算的开源软件。
-
Apache Hadoop是一个大数据处理框架,允许使用简单的编程模型跨计算机集群分布式处理大型数据集。
-
Apache Hadoop可以从单个服务器扩展到数千台计算机
-
Apache Hadoop集群中每台计算机都提供本地计算和存储。
-
Apache Hadoop集群不是依靠硬件来提供高可用性,而是设计了用于检测和处理应用程序层的故障,从而在计算机集群之上提供高可用性服务。
总结:
-
开源软件
-
大数据处理架构
-
单台服务可以,数千台服务器
-
每台服务器都存自己的数据及运算自己的数据
-
把硬件故障认为常态,通过软件把控故障
核心项目
-
Hadoop分布式文件系统(HDFS™):一种分布式文件系统,可提供对应用程序数据的高吞吐量访问。
-
Hadoop YARN:作业调度和集群资源管理的框架。
-
Hadoop MapReduce:基于YARN的系统,用于并行处理大型数据集。
-
Hadoop Common:支持其他Hadoop模块的常用实用程序。
-
Hadoop Ozone: Hadoop集群所提供的对象存储
相关项目
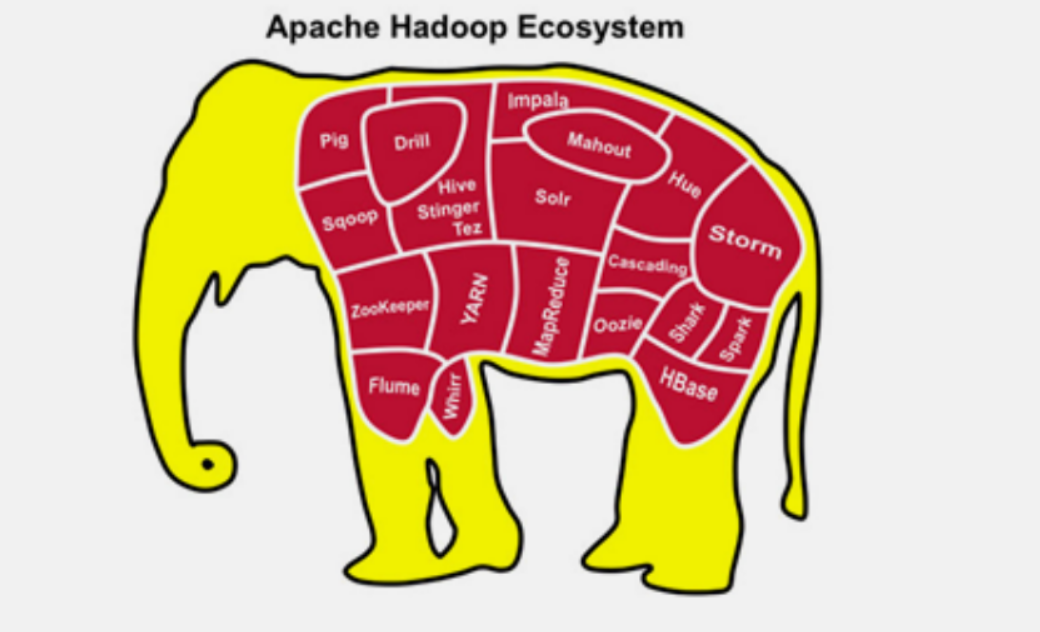
Apache的其他Hadoop相关项目包括:
-
Ambari™
基于Web的工具,用于配置,管理和监控Apache Hadoop集群,包括对Hadoop HDFS,HadoopMapReduce,Hive,HCatalog,HBase,ZooKeeper,Oozie,Pig和Sqoop的支持。
Ambari还提供了一个用于查看集群运行状况的仪表板,例如热图,以及可视化查看MapReduce,Pig和Hive应用程序的功能,以及以用户友好的方式诊断其性能特征的功能。
-
Avro™
数据序列化系统。
-
Cassandra™
可扩展的多主数据库,没有单点故障。
-
Chukwa™
用于管理大型分布式系统的数据收集系统。
-
HBase™
可扩展的分布式数据库,支持大型表的结构化数据存储。
-
Hive™
一种数据仓库基础架构,提供数据汇总和即时查询。
-
Mahout™
可扩展的机器学习和数据挖掘库。
-
Pig™
用于并行计算的高级数据流语言和执行框架。
-
Spark™:
用于Hadoop数据的快速通用计算引擎。Spark提供了一种简单而富有表现力的编程模型,支持广泛的应用程序,包括ETL,机器学习,流处理和图形计算。
-
Tez™
基于Hadoop YARN构建的通用数据流编程框架,它提供了一个功能强大且灵活的引擎,可以执行任意DAG任务来处理批量和交互式用例的数据。Tez正在被Hadoop生态系统中的Hive™,Pig™和其他框架以及其他商业软件(例如ETL工具)采用,以取代Hadoop™MapReduce作为底层执行引擎。
-
ZooKeeper™
用于分布式应用程序的高性能协调服务。
总结:
-
核心项目 hdfs mapreduce yarn
-
相关项目 ambari hbase hive spark zookeeper
五、Hadoop核心项目Hadoop分布式文件系统(HDFS)介绍
目标
-
能够掌握HDFS功能
-
能够掌握HDFS特点
-
能够了解HDFS中Block大小
-
能够掌握HDFS中NameNode作用
-
能够掌握HDFS中DataNode作用
-
能够绘制HDFS写数据流程图
-
能够绘制HDFS读数据流程图
-
Hadoop的基础核心就是HDFS和MapReduce,
-
Hadoop旗下有很多经典子项目,比如HBase、Hive等,这些都是基于HDFS和MapReduce发展出来的。要想了解Hadoop,就必须知道HDFS和MapReduce是什么。
hadoop文件系统定义
-
HDFS(Hadoop Distributed File System,Hadoop分布式文件系统)
-
它是一个高度容错性的系统
-
它适合部署在廉价的机器上
-
它能提供高吞吐量的数据访问
-
它适合那些有着超大数据集(large data set)的应用程序
hadoop文件系统特点
-
支持大数据文件
非常适合上TB级别的大文件或者一堆大数据文件的存储,如果文件只有几个G甚至更小就没啥意思了。
-
支持文件分块存储
HDFS会将一个完整的大文件平均分块存储到不同计算节点上,它的意义在于读取文件时可以同时从多个计算节点上读取不同区块的文件,多主机读取比单主机读取效率要高得多。
-
支持一次写入,多次读取,顺序读取(流式数据访问)
这种模式跟传统文件不同,它不支持动态改变文件内容,而是要求让文件一次写入就不做变化,要变化也只能在文件末添加内容。
-
支持廉价硬件
HDFS可以部署在普通PC机上,这种机制能够让给一些公司用几十台廉价的计算机就可以撑起一个大数据集群。
-
支持硬件故障
HDFS认为所有计算机都可能会出问题,为了防止某个主机失效读取不到该主机的块文件,它将同一个文件块副本分配到其它某几个主机上,如果其中一台主机失效,可以迅速找另一块副本取文件。
总结:
-
支持大文件
-
分块
-
廉价设备
-
支持硬件故障
hadoop分布式文件系统关键词
Block 最基本的存储单位;将文件进行分块处理,通常是128M/块,例如:256M文件会被分为2个Block
Hadoop 1.x版本,Block默认大小为64M;Hadoop 2.x,Block默认大小为128M
Hadoop集群架构(主从架构)
NameNode(主节点)
用于保存整个文件系统的目录信息、文件信息及分块信息,这是由唯一一台主机专门保存,当然这台主机如果 出错,NameNode就失效了。
-
接收用户的操作请求
-
维护文件系统的目录结构
-
管理文件和Block之间的映射管理
-
管理 block 和 DataNode 之间的映射
在Hadoop2.*开始支持activity-standy模式,如果主NameNode失效,启动备用主机运行NameNode。
DataNode(从节点)
分布在廉价的计算机上,用于存储Block块文件。
-
文件被分成块存储到 DataNode 的磁盘上
-
每个Block(块)可以设置多副本
总结:
-
block 文件块 128M/块
-
namenode 目录 文件 分块 接收用户访问 文件与block block与datanode
-
datanode 存block 副本存储
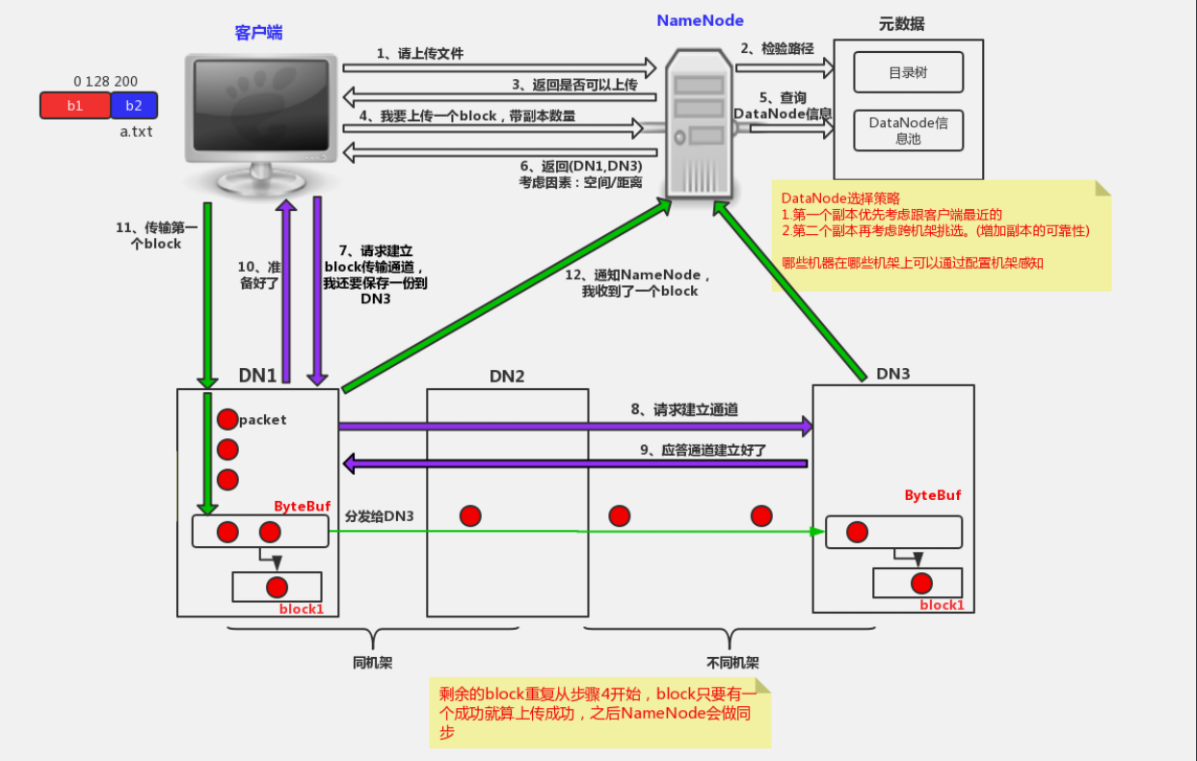
hdfs写数据流程
总结:
-
客户端向namenode发起请求
-
客户端向dn发起建立连接请求
-
客户端向dn存储数据
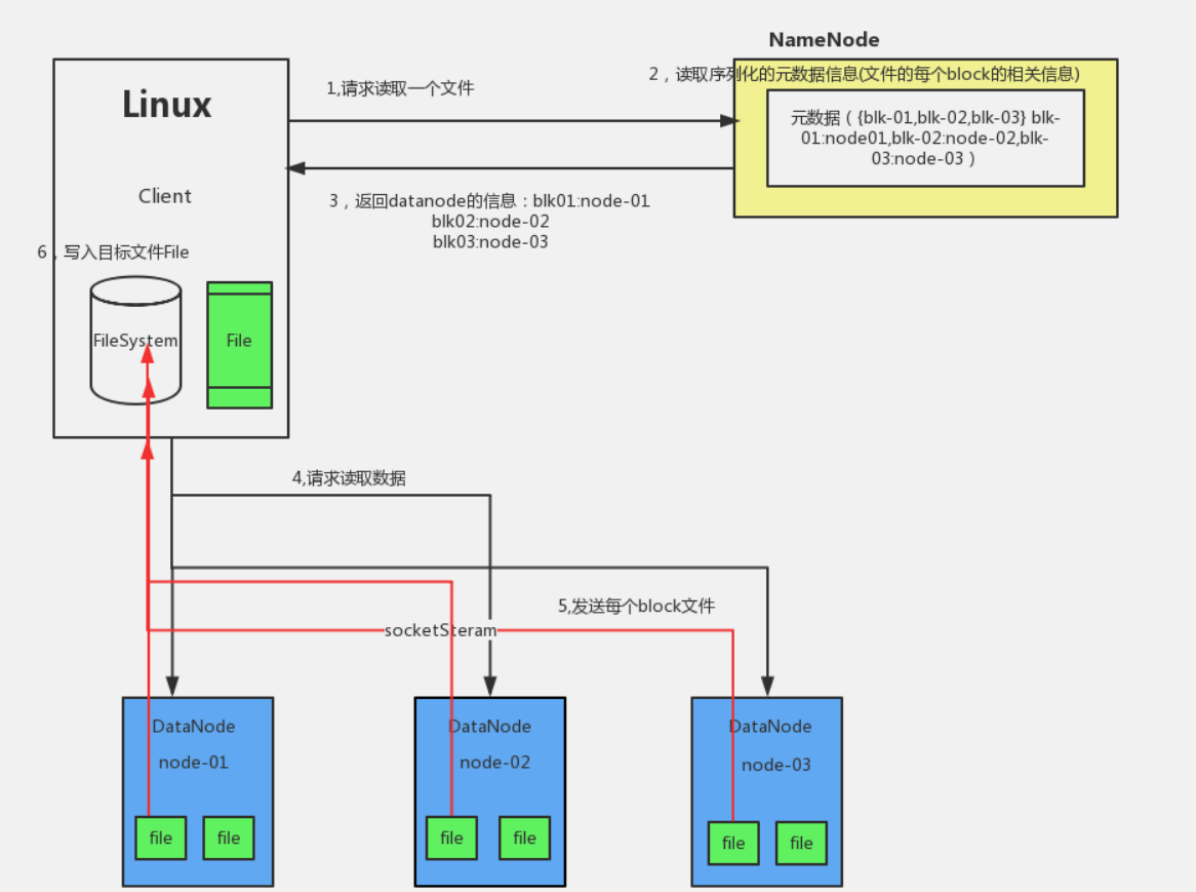
hdfs读数据流程
六、Hadoop核心项目编程模型(MapReduce)介绍
目标
-
能够理解MapReduce作用
-
能够了解MapReduce工作流程
MapReduce作用
通过对HDFS分布式文件系统的了解,我们已经可以把海量数据存储在集群中DataNode之上了,但这仅是Hadoop工作的第一步,那么如何从海量的数据中找到我们所需要的数据呢,这就是MapReduce要做的事情了。下面通过2个例子给予说明
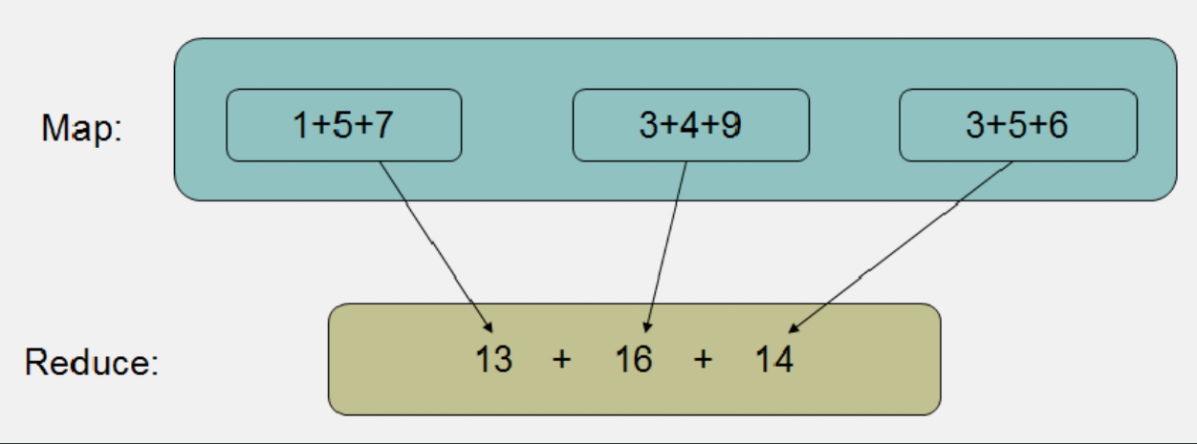
问题: 求和:1+5+7+3+4+9+3+5+6=?
答案:
问题: 一个银行有上亿储户,银行希望找到存储金额最高的金额是多少?
答案 方法1:按照传统的计算方式,我们会这样(java代码):
Long moneys[] ...
Long max = 0L;
for(int i=0;i<moneys.length;i++){
  if(moneys[i]>max){
    max = moneys[i];
  }
}
方法2: 首先数字是分布存储在不同块中的,以某几个块为一个Map,计算出Map中最大的值,然后将每个Map中的最大值 做Reduce操作,Reduce再取最大值给用户。
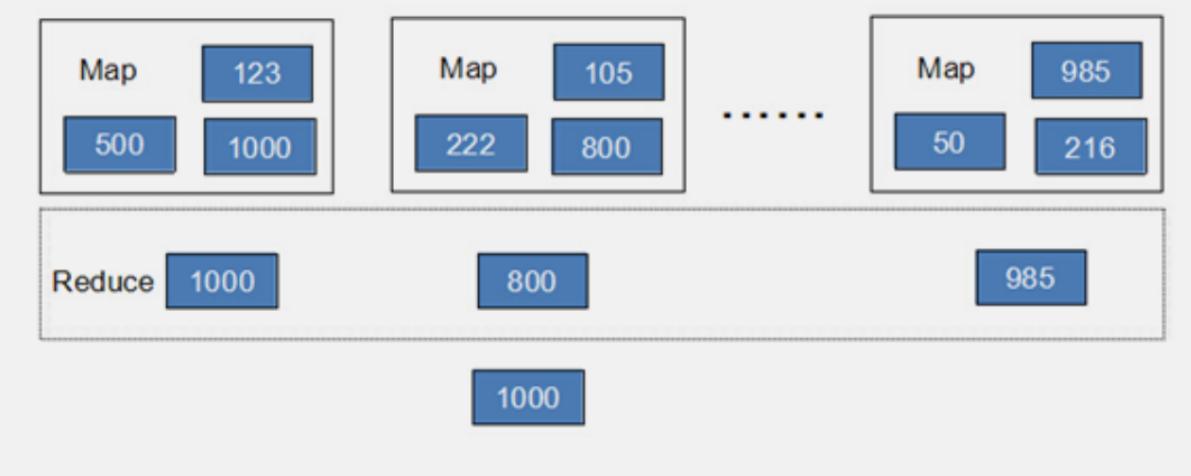
结论: 将大的数据分析分成小块逐个分析,最后再将提取出来的数据汇总分析,最终获得我们想要的内容。 通俗说MapReduce是一套从海量源数据提取、分析元素,最后返回结果集的方法。 当然怎么分块分析,怎么做Reduce操作非常复杂,Hadoop已经提供了数据分析的实现,我们只需要编写简单的需求命令即可达成我们想要的数据。
总结:
-
map 把大数据分成小数据,进行计算 通过洗牌的方式给reduce
-
reduce 对map的结果进行汇总
MapReduce工作流程
MapReduce 框架的核心步骤主要分两部分:Map 和Reduce。
当向MapReduce 框架提交一个计算作业时,它会首先把计算作业拆分成若干个Map 任务,然后分配到不同的节点(DataNode)上去执行,每一个Map 任务处理输入数据中的一部分,当Map 任务完成后,它会生成一些中间文件,这些中间文件将会作为Reduce 任务的输入数据。Reduce 任务的主要目标就是把前面若干个Map 的输出汇总到一起并输出。
从高层抽象来看,MapReduce的数据流图如下图所示:
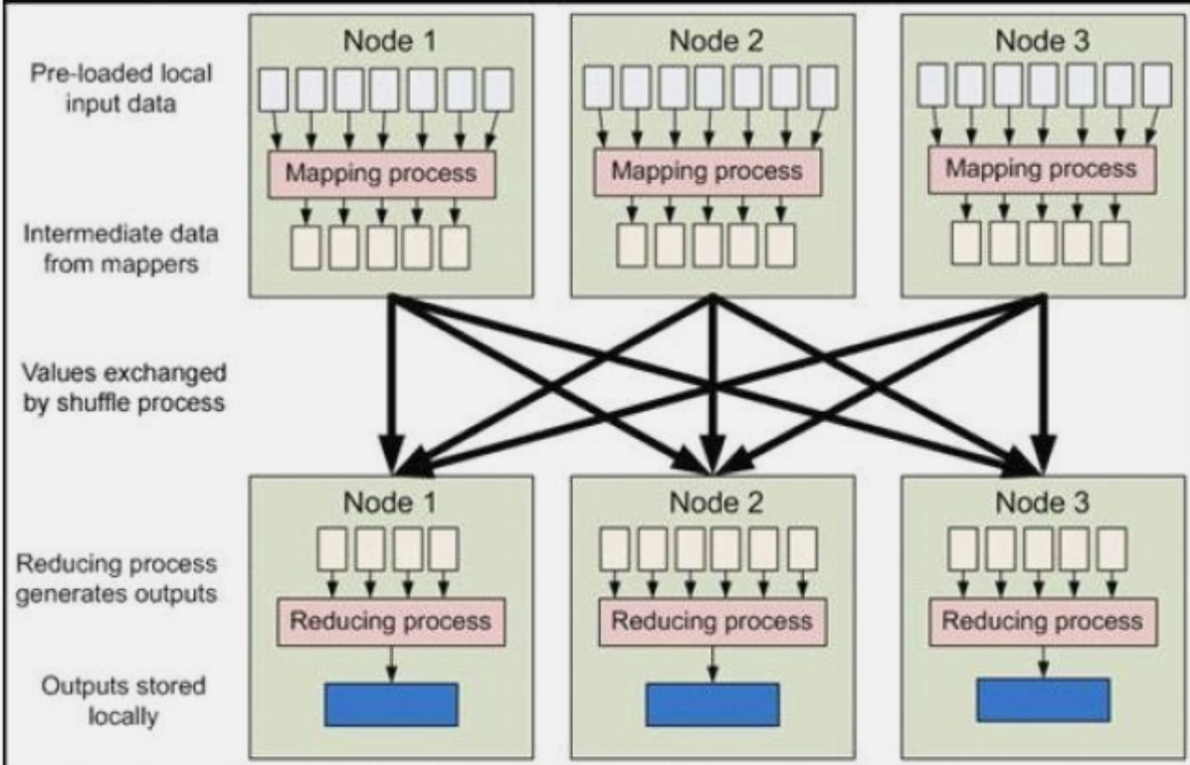
MapReduce工作流程
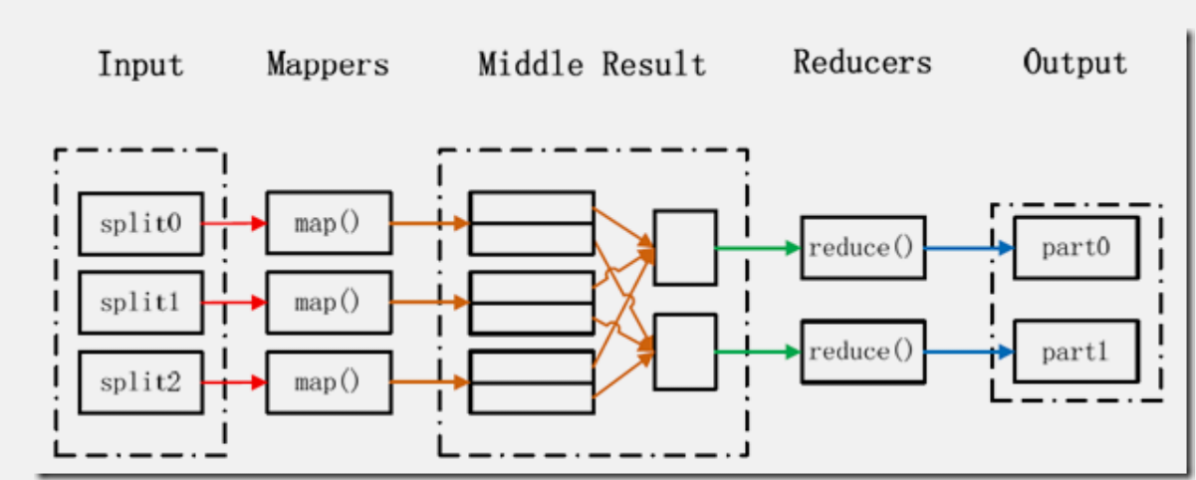
总结:
-
map
-
reduce
七、Hadoop部署区分依据
目标
-
能够了解Hadoop部署的意义
-
能够了解不同部署模式区分依据
要求
通过部署Hadoop过程了解Hadoop工作方式,进一步了解Hadoop工作原理。
本地模式、伪分布式、完全分布式区分依据
主要的区别依据是NameNode、DataNode、ResourceManager、NodeManager等模块运行在几个JVM进程、几个机器。如下表所示:
| 部署模式 | 各个模块占用JVM进程数 | 各个模块运行在几台机器上 |
|---|---|---|
| 单机 | 1 | 1 |
| 伪分布式 | N | 1 |
| 完全分布式 | N | N |
| HA+完全分布式 | N | N |