Hadoop-伪分布部署
伪分布部署
伪分布式部署模式介绍
-
-
该模式在单机模式之上增加了代码调试功能,允许你检查内存使用情况,HDFS输入/输出,以及其他的守护进程交互。
1)上传相应的jar包
下载包的相应网址:
https://mirrors.tuna.tsinghua.edu.cn/apache/hadoop/common/
https://www.oracle.com/java/technologies/downloads/
[root@hadoop-pseudo src]# ll
total 595432
-rw-r--r-- 1 root root 414624228 Nov 30 14:24 hadoop-2.10.2.tar.gz
-rw-r--r-- 1 root root 195094741 Oct 18 11:40 jdk-8u221-linux-x64.tar.gz
2)解压并配置环境
[root@hadoop-pseudo src]# tar xf jdk-8u221-linux-x64.tar.gz
[root@hadoop-pseudo src]# tar xf  hadoop-2.10.2.tar.gz
[root@hadoop-pseudo src]# mv jdk1.8.0_221 /usr/local/jdk
[root@hadoop-pseudo src]# mkdir /apps/ -p
[root@hadoop-pseudo src]# mv hadoop-2.10.2 /apps/hadoop
`添加环境变量`
[root@hadoop-pseudo src]# vim /etc/profile
#最后面添加
export JAVA_HOME=/usr/local/jdk
export HADOOP_HOME=/apps/hadoop
export PATH=${JAVA_HOME}/bin:${HADOOP_HOME}/bin:${HADOOP_HOME}/sbin:$PATH
`让配置文件生效`
[root@hadoop-pseudo src]# source /etc/profile
`验证`
[root@hadoop-pseudo src]# java -version
java version "1.8.0_221"
Java(TM) SE Runtime Environment (build 1.8.0_221-b11)
Java HotSpot(TM) 64-Bit Server VM (build 25.221-b11, mixed mode)
3)修改配置文件
主要涉及的配置文件有:hadoop-env.sh、mapred-env.sh、yarn-env.sh、core-site.xml
3.1)修改hadoop-env.sh、mapred-env.sh、yarn-env.sh文件中JAVA_HOME参数
[root@hadoop-pseudo ~]# vim ${HADOOP_HOME}/etc/hadoop/hadoop-env.sh
#修改为jdk的绝对路径
export JAVA_HOME=/usr/local/jdk
[root@hadoop-pseudo ~]# vim ${HADOOP_HOME}/etc/hadoop/mapred-env.sh
#修改为jdk的绝对路径
export JAVA_HOME=/usr/local/jdk
[root@hadoop-pseudo ~]# vim ${HADOOP_HOME}/etc/hadoop/yarn-env.sh
#修改为jdk的绝对路径
export JAVA_HOME=/usr/local/jdk
3.2)修改core-site.xml
[root@hadoop-pseudo ~]# vim /etc/hosts
127.0.0.1 localhost localhost.localdomain localhost4 localhost4.localdomain4
::1 localhost localhost.localdomain localhost6 localhost6.localdomain6
192.168.139.31 hd1
[root@hadoop-pseudo ~]# vim ${HADOOP_HOME}/etc/hadoop/core-site.xml
<configuration>
<!-- 配置fs.defaultFS -->
<property>
<name>fs.defaultFS</name>
<value>hdfs://hd1:8020</value>
</property>
<!-- 配置hadoop临时目 -->
<property>
<name>hadoop.tmp.dir</name>
<value>/opt/data/tmp</value>
</property>
</configuration>
3.3)配置hdfs-site.xml
[root@hadoop-pseudo ~]# vim ${HADOOP_HOME}/etc/hadoop/hdfs-site.xml
<configuration>
<property>
<name>dfs.replication</name>
<value>1</value>
</property>
</configuration>
dfs.replication配置的是HDFS存储时的备份数量,因为这里是伪分布式环境只有一个节点,所以这里设置为1。
3.4)格式化hdfs
[root@hadoop-pseudo ~]# hdfs namenode -format
-
格式化是对HDFS这个分布式文件系统中的DataNode进行分块,统计所有分块后的初始元数据的存储在NameNode中。
-
格式化后,查看core-site.xml里hadoop.tmp.dir(本例是/opt/data目录)指定的目录下是否有了dfs目录,如果有,说明格式化成功。
[root@hadoop-pseudo ~]# ll /opt/data/tmp/dfs/name/current/
total 16
-rw-r--r-- 1 root root 323 Nov 30 15:32 fsimage_0000000000000000000
-rw-r--r-- 1 root root 62 Nov 30 15:32 fsimage_0000000000000000000.md5
-rw-r--r-- 1 root root 2 Nov 30 15:32 seen_txid
-rw-r--r-- 1 root root 218 Nov 30 15:32 VERSION
# fsimage是NameNode元数据在内存满了后,持久化保存到的文件。
# fsimage*.md5 是校验文件,用于校验fsimage的完整性。
# seen_txid 是hadoop的版本
# vession文件里保存:
-
namespaceID:NameNode的唯一ID。
-
clusterID:集群ID,NameNode和DataNode的集群ID应该一致,表明是一个集群
4)启动角色
4.1)启动namenode
[root@hadoop-pseudo ~]# hadoop-daemon.sh start namenode
4.2)启动datanode
[root@hadoop-pseudo ~]# hadoop-daemon.sh start datanode
4.3)验证
[root@hadoop-pseudo ~]# jps
13379 NameNode
13469 DataNode
13549 Jps
5) HDFS上测试创建目录、上传、下载文件
5.1)创建目录
[root@hadoop-pseudo ~]# hdfs dfs -mkdir -p /test/input
5.2)上传文件
[root@hadoop-pseudo ~]# echo 123456 > test.txt
[root@hadoop-pseudo ~]# hdfs dfs -put /root/test.txt /test/input
5.3)读取内容
[root@hadoop-pseudo ~]# hdfs dfs -cat /test/test.txt
123456
5.4)下载文件到本地
[root@hadoop-pseudo ~]# hdfs dfs -get /test/test.txt /tmp/
[root@hadoop-pseudo ~]# cat /tmp/test.txt
123456
6)配置yarn
6.1)Yarn介绍
-
A framework for job scheduling and cluster resource management.
功能:任务调度 和 集群资源管理
-
YARN (Yet An other Resouce Negotiator) 另一种资源协调者
是 Hadoop 2.0新增加的一个子项目,弥补了Hadoop 1.0(MRv1)扩展性差、可靠性资源利用率低以及无法支持其他计算框架等不足。
-
Hadoop的下一代计算框架MRv2将资源管理功能抽象成一个通用系统YARN
-
MRv1的 jobtracker和tasktrack也不复存在,计算框架 (MR, storm, spark)同时运行在之上,使得hadoop进入了多计算框架的弹性平台时代。
总结:
-
yarn是一种资源协调者
-
从mapreduce拆分而来
-
带来的好处:让hadoop平台性能及扩展性得到更好发挥
6.2)使用Yarn好处
-
在某些时间,有些资源计算框架的集群紧张,而另外一些集群资源空闲。 那么这框架共享使用一个则可以大提高利率些集群资源空闲。
-
维护成本低。
-
数据共享。 避免了集群之间移动数据。
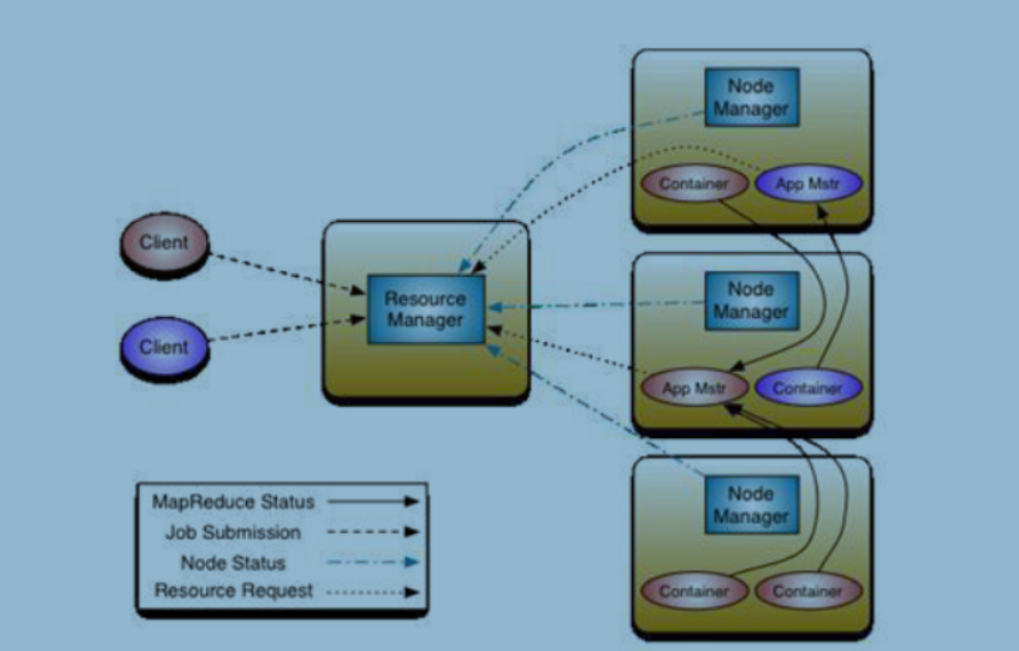
YARN 主从架构
-
ResourceManager 资源管理
-
NodeManager 节点管理
-
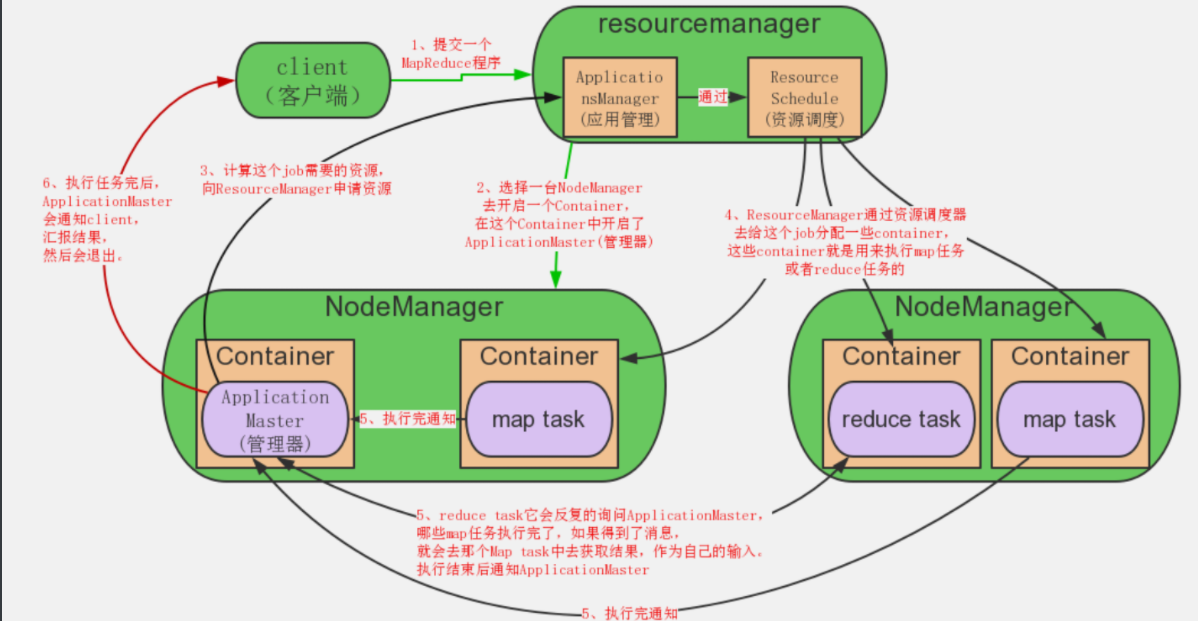
ResourceManager负责对各个NodeManager 上的资源进行统一管理和任务调度。
-
NodeManager在各个计算节点运行,用于接收RM中ApplicationsManager 的计算任务、启动/停止任务、和RM中Scheduler 汇报并协商资源、监控并汇报本节点的情况。
6.3) 配置mapred-site.xml
默认没有mapred-site.xml文件,但是有个mapred-site.xml.template配置模板文件。复制模板生成mapred-site.xml
[root@hadoop-pseudo ~]# cp /apps/hadoop/etc/hadoop/mapred-site.xml.template /apps/hadoop/etc/hadoop/mapred-site.xml
[root@hadoop-pseudo ~]# vim /apps/hadoop/etc/hadoop/mapred-site.xml
<configuration>
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
</configuration>
指定mapreduce运行在yarn框架上。
6.4)配置yarn-site.xml
[root@hadoop-pseudo ~]# vim /apps/hadoop/etc/hadoop/yarn-site.xml
<configuration>
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<property>
<name>yarn.resourcemanager.hostname</name>
<value>hd1</value>
</property>
</configuration>
-
yarn.nodemanager.aux-services配置了yarn的默认混洗方式,选择为mapreduce的默认混洗算法。
-
yarn.resourcemanager.hostname指定了Resourcemanager运行在哪个节点上。
6.5)启动yarn
[root@hadoop-pseudo ~]# yarn-daemon.sh start resourcemanager
starting resourcemanager, logging to /apps/hadoop/logs/yarn-root-resourcemanager-hadoop-pseudo.out
[root@hadoop-pseudo ~]# yarn-daemon.sh start nodemanager
starting nodemanager, logging to /apps/hadoop/logs/yarn-root-nodemanager-hadoop-pseudo.out
[root@hadoop-pseudo ~]# jps
14993 Jps
14630 ResourceManager
14349 NameNode
14445 DataNode
14877 NodeManager
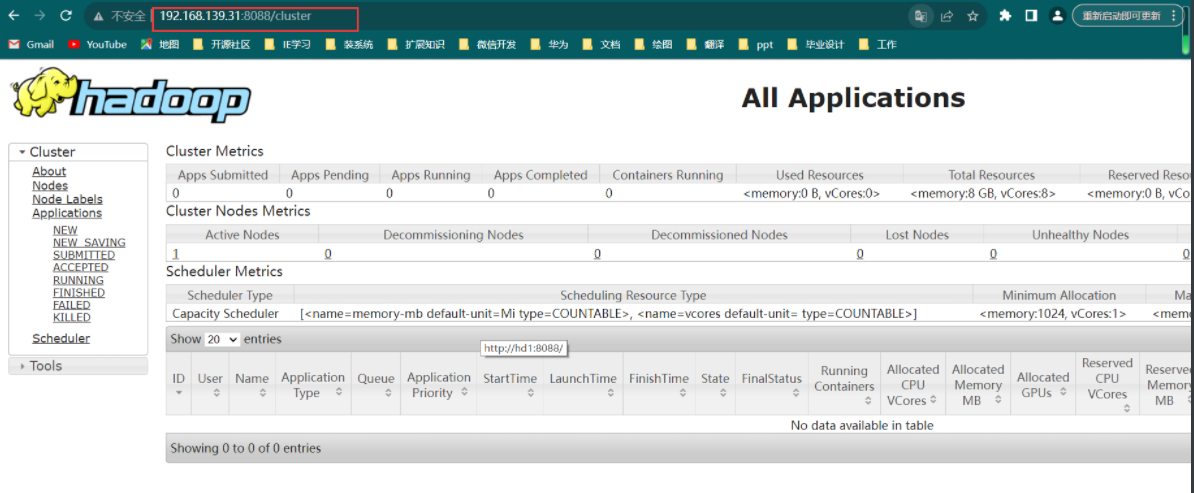
6.6)YARN的Web页面
6.7)测试
在Hadoop的share目录里,自带了一些jar包,里面带有一些mapreduce实例小例子,位置在share/hadoop/mapreduce/hadoop-mapreduce-examples-2.8.5.jar,可以运行这些例子体验刚搭建好的Hadoop平台,我们这里来运行最经典的WordCount实例。
创建目录
[root@hadoop-pseudo ~]# hdfs dfs -mkdir /test
[root@hadoop-pseudo ~]# hdfs dfs -mkdir /test/input
上传文件
[root@pseudo ~]# vim test.txt
nihap
12333
123332
12333
192.168.139.33
192.168.139.33
192.168.139.31
[root@hadoop-pseudo ~]# hdfs dfs -put /root/test.txt /test/input
运行实例
[root@hadoop-pseudo logs]# hadoop jar /apps/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.10.2.jar wordcount /test/input /test/output/00
`或者`
[root@hadoop-pseudo logs]# yarn jar /apps/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.10.2.jar wordcount /test/input /test/output/00
查看输出结果
[root@hadoop-pseudo ~]# hdfs dfs -ls /test/output/00
Found 2 items
-rw-r--r--   1 root supergroup          0 2023-11-30 21:43 /test/output/00/_SUCCESS
-rw-r--r--   1 root supergroup         59 2023-11-30 21:43 /test/output/00/part-r-00000
[root@hadoop-pseudo ~]# hdfs dfs -cat  /test/output/00/part-r-00000
12333   2
123332  1
192.168.139.31  1
192.168.139.33  2
nihap   1
7)停止hadoop
[root@hadoop-pseudo ~]# hadoop-daemon.sh stop namenode
[root@hadoop-pseudo ~]# hadoop-daemon.sh stop datanode
[root@hadoop-pseudo ~]# yarn-daemon.sh stop resourcemanager
[root@hadoop-pseudo ~]# yarn-daemon.sh stop nodemanager