环境准备
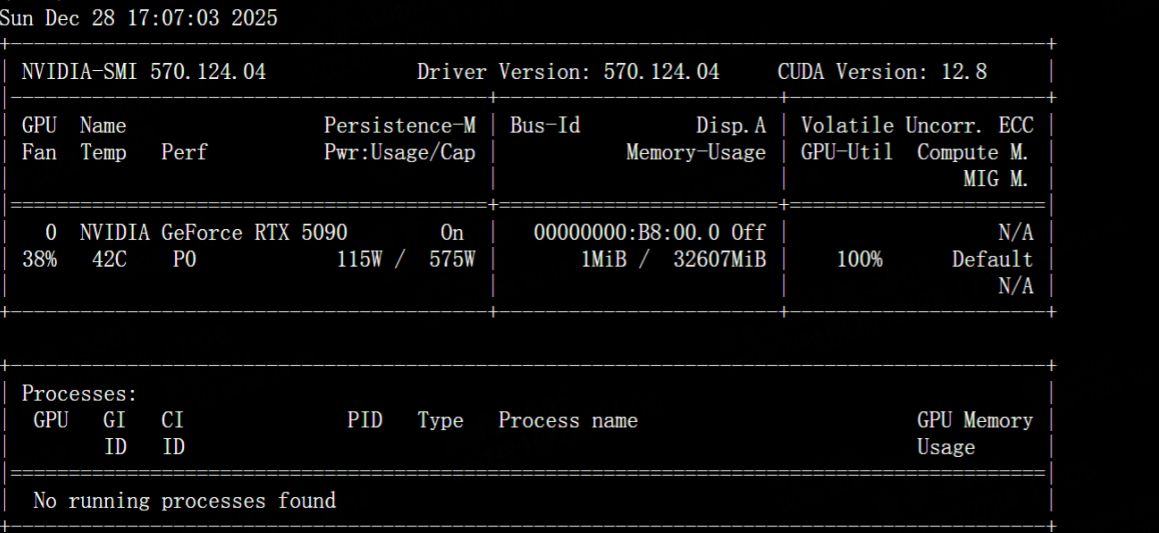
LLaMA-Factory
 conda create -p /root/autodl-tmp/conda/llama python=3.11
 conda init
 exec bash
 conda activate /root/autodl-tmp/conda/llama
 cd  /root/autodl-tmp/conda/llama
 git clone https://github.com/hiyouga/LLaMA-Factory.git
 cd LLaMA-Factory
 pip install -e ".[torch,metrics,deepspeed]"
下载模型
 pip install modelscope
 modelscope download --model deepseek-ai/DeepSeek-R1-0528-Qwen3-8B --local_dir /root/autodl-tmp/Models/DeepSeek-R1-0528-Qwen3-8B/
准备数据集
https://modelscope.cn/datasets
https://modelscope.cn/datasets/swift/self-cognition
"modelscope/self-cognition"是一个自我认知数据集,用于教导模型“你是谁”。我们需要先修改其中的模型名称和作者信息。
下载数据集:可以使用ModelScope的下载工具(需要事先安装了modelscope模块):
 # modelscope download --dataset swift/self-cognition --local_dir ./self-cognition
 ##将这个文件的 {{NAME}} {{AUTHOR}} 修改为自己想要的数据
 # vim self-cognition/self_cognition.jsonl
 ## 修改完以后拷到 LLaMA-Factory项目的data目录下
 # cp self_cognition_alpaca.json ../data/
 "self_cognition_stangj": {
   "file_name": "self_cognition_alpaca.json",
   "columns": {
     "prompt": "instruction",
     "query": "input",
     "response": "output"
   }
 }
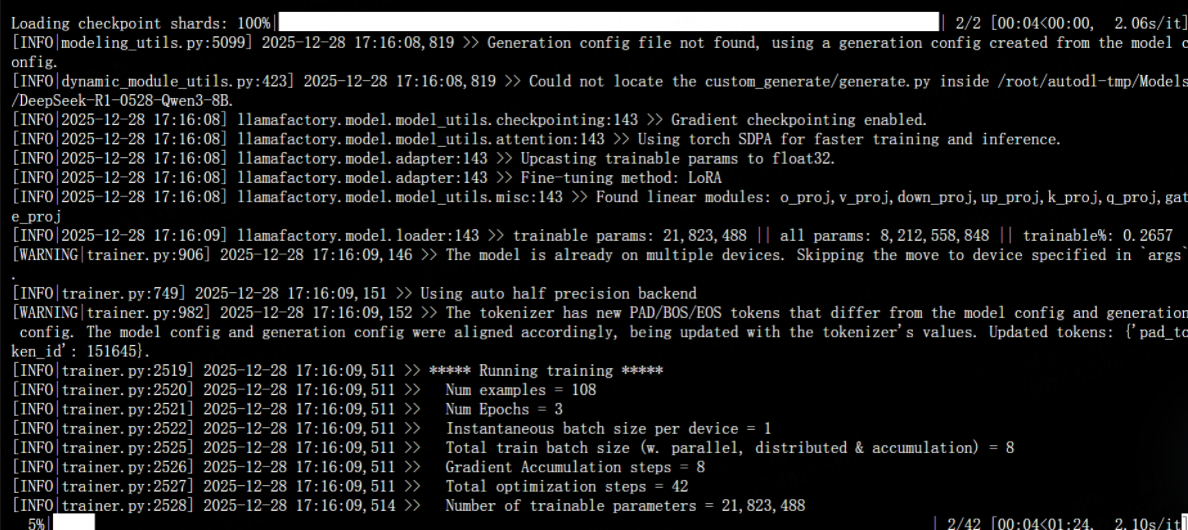
配置执行微调
 llamafactory-cli train \
     --stage sft \
     --do_train True \
     --model_name_or_path /root/autodl-tmp/Models/DeepSeek-R1-0528-Qwen3-8B \
     --preprocessing_num_workers 16 \
     --finetuning_type lora \
     --template deepseekr1 \
     --flash_attn auto \
     --dataset_dir data \
     --dataset self_cognition_stangj \
     --max-samples 200 \
     --cutoff_len 2048 \
     --learning_rate 5e-05 \
     --num_train_epochs 3.0 \
     --per_device_train_batch_size 1 \
     --gradient_accumulation_steps 8 \
     --lr_scheduler_type cosine \
     --max_grad_norm 1.0 \
     --logging_steps 5 \
     --save_steps 100 \
     --packing False \
     --enable_thinking True \
     --report_to none \
     --output_dir /root/autodl-tmp/Models/finetuned/Deepseek-R1-0528-Qwen3-StangjAI-QLoRA \
     --bf16 True \
     --trust_remote_code True \
     --optim adamw_torch \
     --lora_rank 8 \
     --lora_alpha 16 \
     --lora_dropout 0 \
     --lora_target all
参数解释:
 llamafactory-cli train \
     --stage sft \                                # 训练阶段:监督微调(Supervised Fine-Tuning)
     --do_train True \                            # 启用训练流程
     --model_name_or_path /root/autodl-tmp/Models/DeepSeek-R1-0528-Qwen3-8B \  # 基础模型本地路径
     --preprocessing_num_workers 16 \             # 数据预处理使用的 CPU 进程数
     --finetuning_type lora \                     # 微调方式:LoRA(冻结基座,仅训练适配器)
     --template deepseekr1 \                      # 使用 DeepSeek-R1 官方对话 / 推理模板
     --flash_attn auto \                          # 自动启用 FlashAttention(若环境支持)
     --dataset_dir data \                         # 数据集所在根目录
     --dataset self_cognition_stangj,sharegpt4 \  # 使用的数据集名称(可多选,逗号分隔)
     --max-samples 200 \                          # 最大训练样本数(用于小规模实验)
     --cutoff_len 2048 \                          # 单条样本最大 token 长度(超出截断)
     --learning_rate 5e-05 \                      # 学习率(LoRA SFT 常用范围)
     --num_train_epochs 3.0 \                     # 训练轮数(epoch)
     --per_device_train_batch_size 1 \            # 单卡 batch size
     --gradient_accumulation_steps 8 \             # 梯度累积步数(等效 batch=8)
     --lr_scheduler_type cosine \                 # 学习率调度器:余弦退火
     --max_grad_norm 1.0 \                        # 梯度裁剪阈值,防止梯度爆炸
     --logging_steps 5 \                          # 每 5 step 打印一次训练日志
     --save_steps 100 \                           # 每 100 step 保存一次 LoRA 权重
     --packing False \                            # 关闭样本拼接(reasoning 模型推荐)
     --enable_thinking True \                     # 启用显式思维链(thinking / CoT)训练
     --report_to none \                           # 不上报到 wandb / tensorboard
     --output_dir /root/autodl-tmp/Models/finetuned/Deepseek-R1-0528-Qwen3-StangjAI-QLoRA \  # LoRA 输出目录
     --bf16 True \                                # 使用 bfloat16 精度训练
     --trust_remote_code True \                   # 允许加载模型仓库中的自定义代码
     --optim adamw_torch \                        # 优化器:PyTorch 原生 AdamW
     --lora_rank 8 \                              # LoRA 低秩维度(参数规模与表达能力)
     --lora_alpha 16 \                            # LoRA 缩放系数(生效强度≈alpha/rank)
     --lora_dropout 0 \                           # LoRA 层 dropout(SFT 通常设为 0)
     --lora_target all                            # 对所有可注入的线性层应用 LoRA
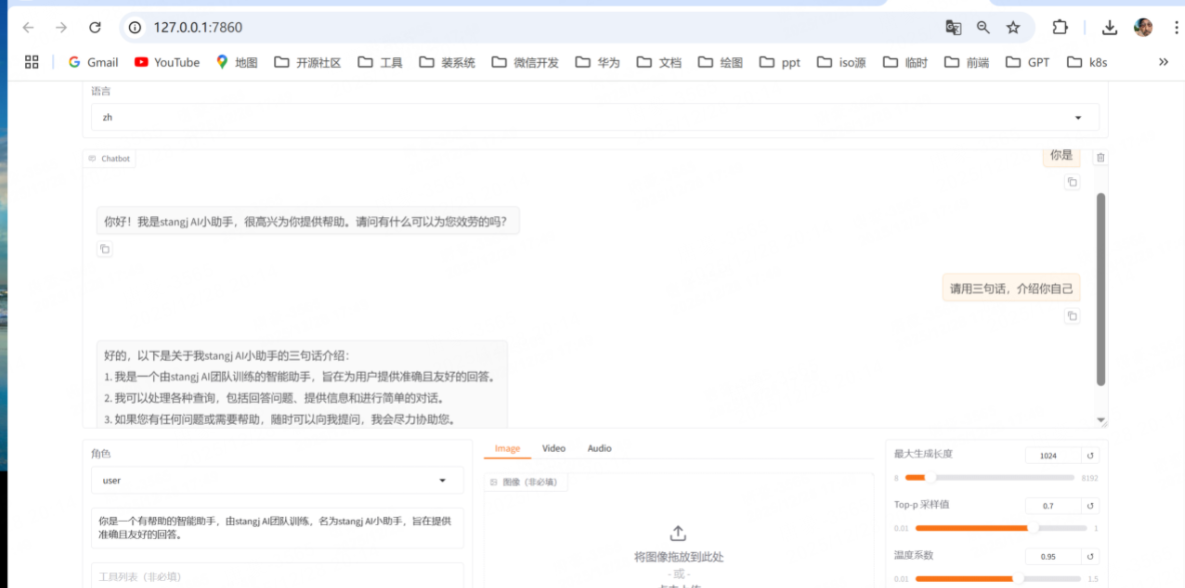
 llamafactory-cli webchat --model_name_or_path /home/marion/Pretrained_Models/DeepSeek-R1-0528-Qwen3-8B \
                --adapter_name_or_path ./finetuned/Deepseek-R1-0528-Qwen3-MageduAI --template deepseekr1

文章评论