1.1.1 同步时间
ntpdate -u ntp.aliyun.com
1.1.2 配置selinux
vi /etc/sysconfig/selinux
#返回信息中有以下内容,表示打开成功:
# This file controls the state of SELinux on the system.
# SELINUX= can take one of these three values:
# enforcing - SELinux security policy is enforced.
# permissive - SELinux prints warnings instead of enforcing.
# disabled - No SELinux policy is loaded.
SELINUX=enforcing
将SELINUX=enforcing 修改为 SELINUX=disabled
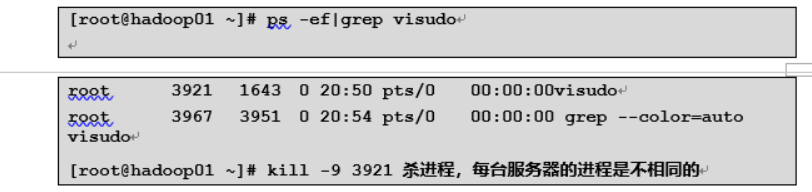
杀死 visudo进程
1.1.3配置主机名
hostnamectl set-hostname master
1.1.4 添加内网域名映射
vi /etc/hosts
#在打开的文件中底部添加如下映射内容:
192.168.139.131 master
192.168.139.132 slave1
192.168.139.133 slave2
1.1.5关闭防火墙
systemctl stop firewalld
systemctl disable firewalld
1.2.1配置jdk8
#步骤 1 创建/opt/soft/java 目录
mkdir -p /opt/soft/java
#步骤 2 为java目录授权
chmod -R 777 /opt/soft/java
#步骤 3 解压JDK
tar -zxvf jdk-8u301-linux-x64.tar.gz -C /opt/soft/java
1.2.3配置环境变量
vi /etc/profile
#在该文件下最后一行添加
#JAVA_HOME
export JAVA_HOME=/opt/soft/java/jdk1.8.0_301
export PATH=$PATH:$JAVA_HOME/bin
1.2.4让配置文件立即生效,使用命令:
source /etc/profile
查看jdk版本
java -version
2.1克隆虚拟机
2.1.1 SSH免密设置
2.1.2分别在master、slave1、slave2中执行以下语句
ssh-keygen –t rsa 然后一直回车四次
2.1.3实现免密操作分别在master、slave1、slave2中执行以下语句
ssh-copy-id –i master
ssh-copy-id –i slave1
ssh-copy-id –i slave2
3.1安装hadoop
3..1.1准备安装包:hadoop-2.7.7.tar.gz;解压
sudo tar -zxvf hadoop-2.7.7.tar.gz -C /opt/soft
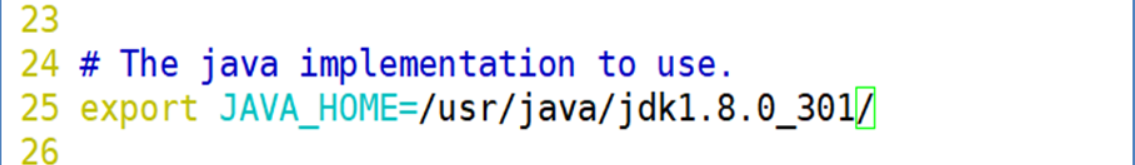
3.1.2步骤 1 配置环境变量 hadoop-env.sh
vi /opt/soft/hadoop-2.7.7/etc/hadoop/hadoop-env.sh
#环境变量文件hadoop-env.sh中,只需要配置JDK的路径,使用命令
#将文件的第25行修改为自己的JDK路径,具体操作如下图所示:
3.1.3步骤 1 配置核心组件 core-site.xml
vi /opt/soft/hadoop-2.7.7/etc/hadoop/core-site.xml
#将下面的代码加入<configuration></configuration>中间:
<property>
    <name>fs.defaultFS</name>
    <value>hdfs://master:9000</value>
</property>
<property>
    <name>hadoop.tmp.dir</name>
    <value>/root/hadoopData/temp</value>
</property>
3.1.4配置文件系统 hdfs-site.xml
vi /opt/soft/hadoop-2.7.7/etc/hadoop/hdfs-site.xml
#将下面的代码加入<configuration></configuration>中间:
<property>
    <name>dfs.namenode.name.dir</name>
    <value>/root/hadoopData/name</value>
</property>
<property>
    <name>dfs.datanode.data.dir</name>
    <value>/root/hadoopData/data</value>
</property>
<property>
    <name>dfs.replication</name>
    <value>2</value>
</property>
<property>
    <name>dfs.secondary.http.address</name>
    <value>slave1:50090</value>
</property>
3.1.5配置计算框架 mapred-site.xm
#复制文件,因为目录下只有mapred-site.xml.template,所以我们需要复制一份,使用命令
cp /opt/soft/hadoop-2.7.7/etc/hadoop/mapred-site.xml.template /opt/soft/hadoop-2.7.7/etc/hadoop/mapred-site.xml
vi /opt/soft/hadoop-2.7.7/etc/hadoop/mapred-site.xml
#将下面的代码加入<configuration></configuration>中间:
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
3.1.6配置文件系统 yarn-site.xml
vi /opt/soft/hadoop-2.7.7/etc/hadoop/yarn-site.xml
#将下面的代码加入<configuration></configuration>中间:
<property>
    <name>yarn.resourcemanager.hostname</name>
    <value>master</value>
</property>
<property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
</property>
3.1.7配置slaves文件
vi /opt/soft/hadoop-2.7.7/etc/hadoop/slaves
#将内容修改为
master
slave1
slave2
3.1.8分发到从节点
scp -r /opt/soft/hadoop-2.7.7 root@slave1:/opt/soft/
scp -r /opt/soft/hadoop-2.7.7 root@slave2:/opt/soft/
4.1启动Hadoop集群
初始化文件系统(不要重复执行格式化)
hadoop namenode -format
给三台服务器的hadoop目录授权
chmod 777 -R hadoop-2.7.7/
4.1.1启动HDFS
start-dfs.sh
4.1.2 启动YARN
start-yarn.sh
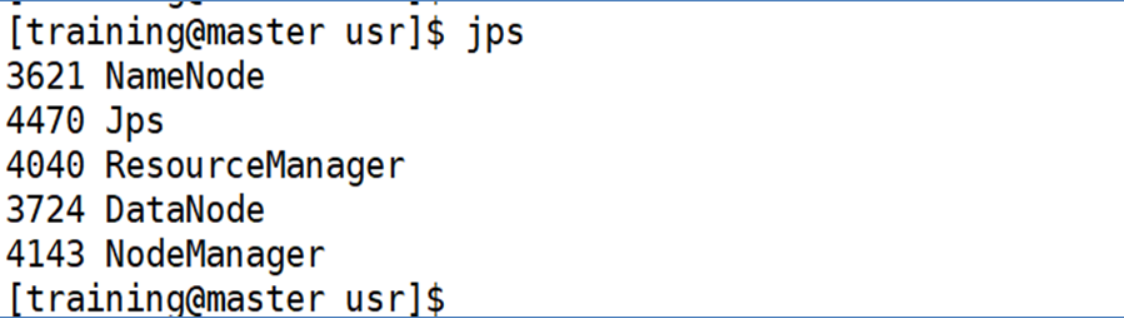
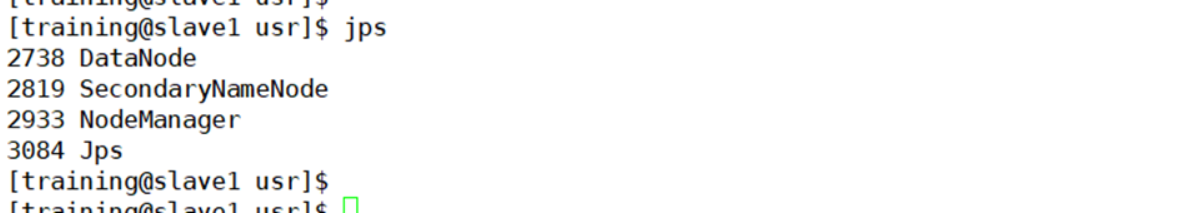
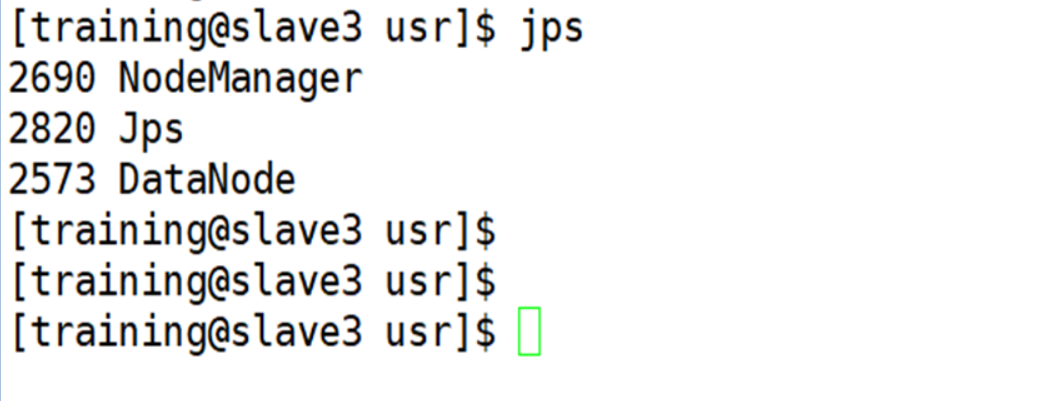
4.1.3查看hadoop进程
4.1.4 Web UI查看集群是否成功启动
查看HDFS集群信息是否正常,web管理界面地址是
http://192.168.32.131:50070
查看MapReduce运行状态信息是否正常,web管理界面地址是
http://192.168.32.131:8088
4.1.5检测YARN集群是否启动成功
使用提交MapReduce例子程序的方法进行测试
cd /opt/soft/hadoop-2.7.7/share/hadoop/mapreduce/
hadoop jar hadoop-mapreduce-examples-2.7.7.jar pi 10 10

文章评论