完全分布式部署介绍
完全分部式是真正利用多台Linux主机来进行部署Hadoop,对Linux机器集群进行规划,使得Hadoop各个模块分别部署在不同的多台机器上
架构
| 主机名 | IP | 角色 |
|---|---|---|
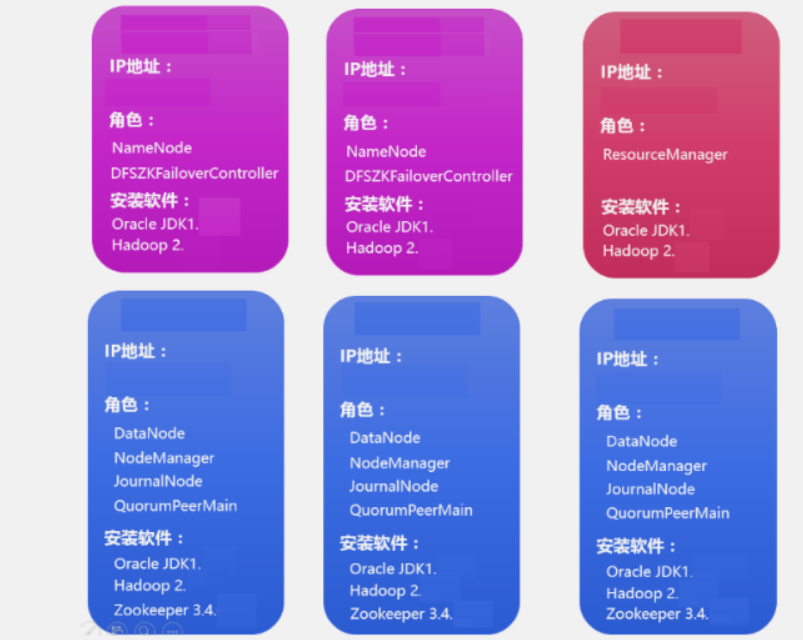
| hd1 | 192.168.139.31 | NameNode |
| hd2 | 192.168.139.32 | NameNode |
| hd3 | 192.168.139.33 | ResourceManager |
| hd4 | 192.168.139.34 | DataNode;NodeManager;Zookeeper;Journalnode |
| hd5 | 192.168.139.35 | DataNode;NodeManager;Zookeeper;Journalnode |
| hd6 | 192.168.139.36 | DataNode;NodeManager;Zookeeper;Journalnode |
NameNode HA+完全分布式部署
目标
-
能够了解HA+完成分布式部署场景
-
能够对HA+完全分布式部署架构规划
-
能够对HA+完全分布式部署进行配置
什么是HA?
-
HA的意思是High Availability高可用,指当当前工作中的机器宕机后,会自动处理这个异常,并将工作无缝地转移到其他备用机器上去,以来保证服务的高可用。
-
HA方式安装部署才是最常见的生产环境上的安装部署方式。Hadoop HA是Hadoop 2.x中新添加的特性,包括NameNode HA 和 ResourceManager HA。因为DataNode和NodeManager本身就是被设计为高可用的,所以不用对他们进行特殊的高可用处理。
NameNode HA切换实现方法
-
Hadoop2.X对NameNode进行一个抽象:NameService 一个NameService下面有两个NameNode,分别处于Active和Standby状态。
-
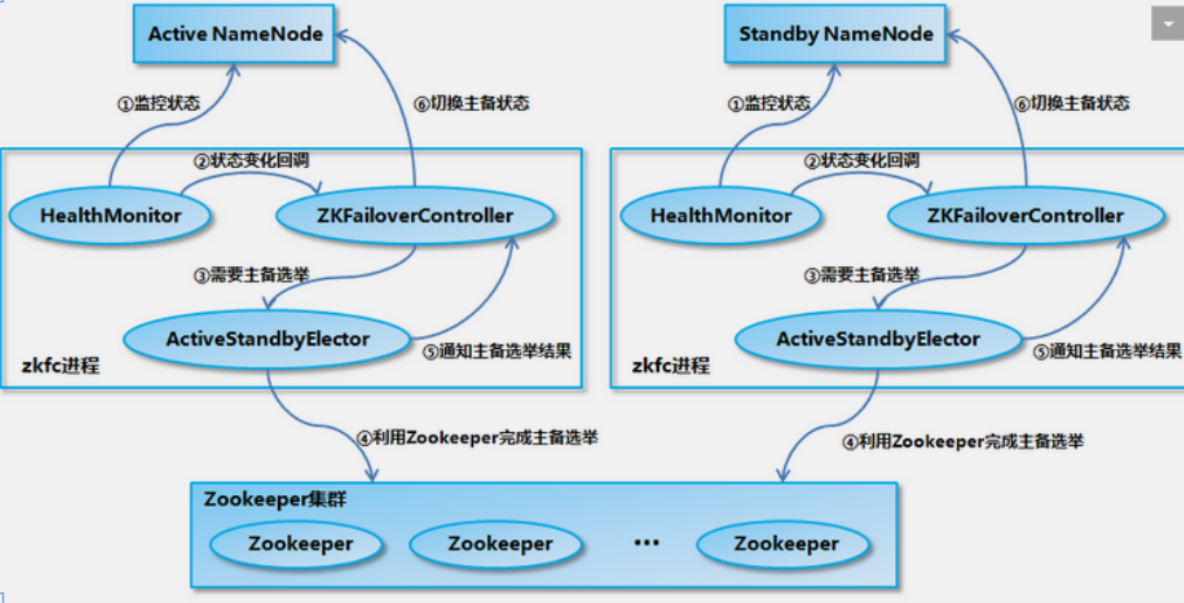
通过Zookeeper进行协调选举,确保只有一个活跃的NameNode。一旦主(Active)宕掉,standby会切换成Active。
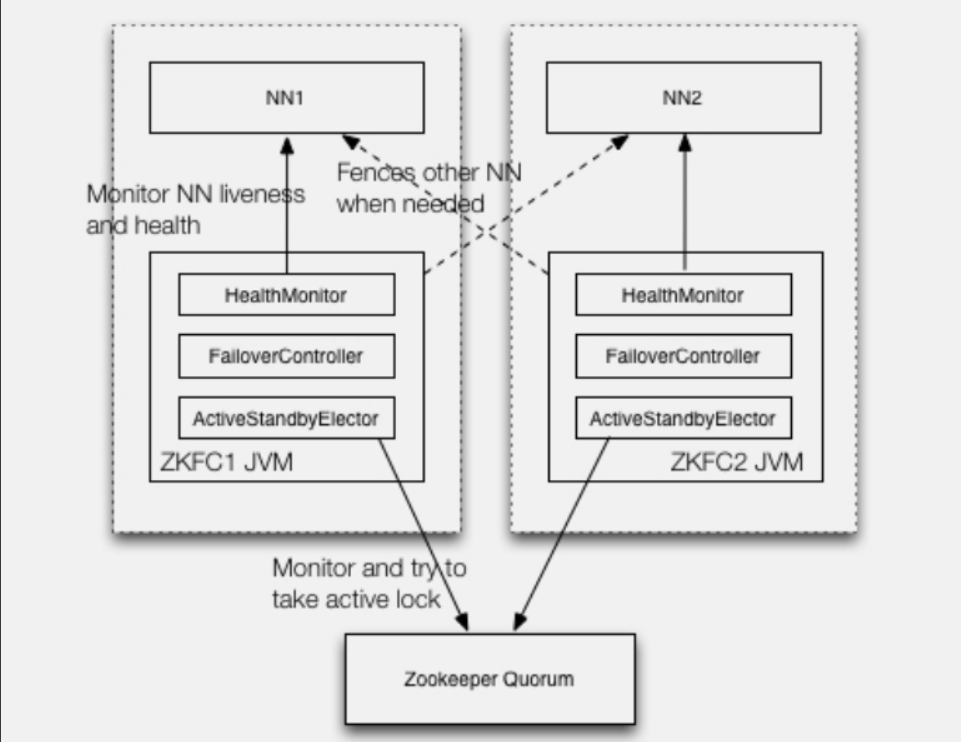
作为一个ZK集群的客户端,用来监控NN的状态信息。每个运行NN的节点必须要运行一个zkfc。zkfc提供以下功能:
Health monitoring
zkfc定期对本地的NN发起health-check的命令,如果NN正确返回,那么这个NN被认为是OK的。否则被认为是失效节点。
ZooKeeper session management
当本地NN是健康的时候,zkfc将会在zk中持有一个session。如果本地NN又正好是active的,那么zkfc还有持有一个"ephemeral"的节点作为锁,一旦本地NN失效了,那么这个节点将会被自动删除。
ZooKeeper-based election
如果本地NN是健康的,并且zkfc发现没有其他的NN持有那个独占锁。那么他将试图去获取该锁,一旦成功,那么它就需要执行Failover,然后成为active的NN节点。Failover的过程是:第一步,对之前的NN执行fence,如果需要的话。第二步,将本地NN转换到active状态。
NameNode HA数据共享方法
Namenode主要维护两个文件,一个是fsimage,一个是editlog。
fsimage保存了最新的元数据检查点,包含了整个HDFS文件系统的所有目录和文件的信息。对于文件来说包括了数据块描述信息、修改时间、访问时间等;对于目录来说包括修改时间、访问权限控制信息(目录所属用户,所在组)等。
editlog主要是在NameNode已经启动情况下对HDFS进行的各种更新操作进行记录,HDFS客户端执行所有的写操作都会被记录到editlog中
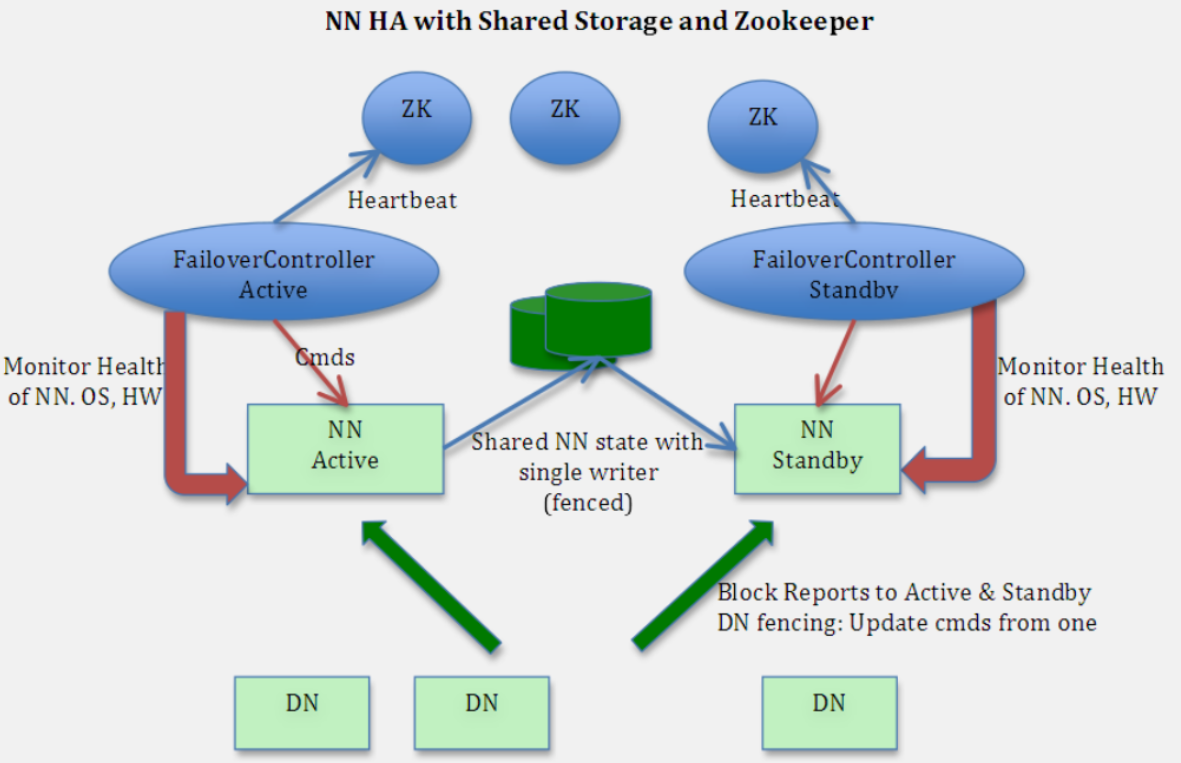
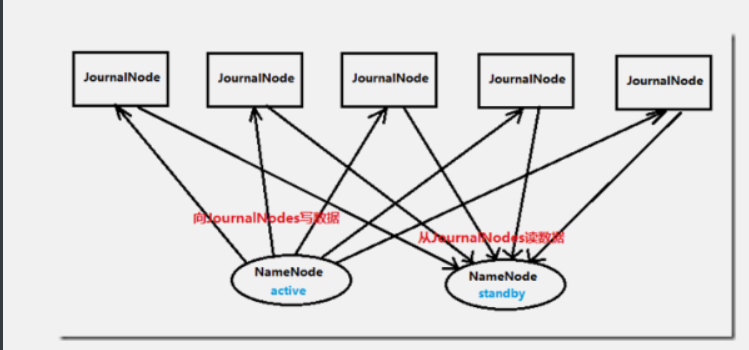
上面在Active Namenode与StandBy Namenode之间的绿色区域就是JournalNode,当然数量不一定只有1个,作用相当于NFS共享文件系统,Active Namenode往里写editlog数据,StandBy再从里面读取数据进行同步。
两个NameNode为了数据同步,会通过一组称作JournalNodes的独立进程进行相互通信。当active状态的NameNode的命名空间有任何修改时,会告知大部分的JournalNodes进程。standby状态的NameNode有能力读取JNs中的变更信息,并且一直监控edit log的变化,把变化应用于自己的命名空间。standby可以确保在集群出错时,命名空间状态已经完全同步了。
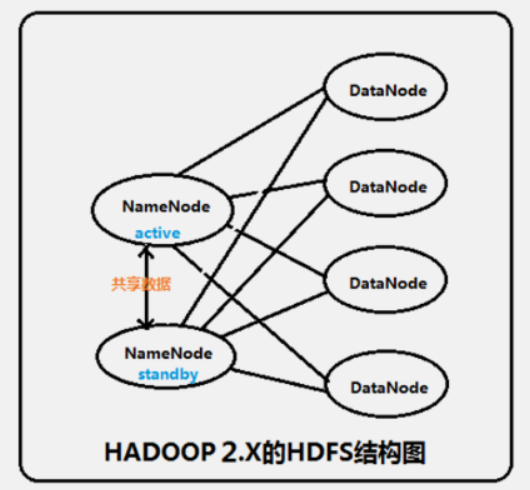
集群启动时,可以同时启动2个NameNode。这些NameNode只有一个是active的,另一个属于standby状态。active状态意味着提供服务,standby状态意味着处于休眠状态,只进行数据同步,时刻准备着提供服务
部署规划
实施
1)系统时间同步
六台都要做,我这里演示一台
[root@hd1 ~]# ntpdate time1.aliyun.com
2)设置主机IP及名称解析
六台都要做,我这里演示一台
[root@hd1 ~]# cat /etc/hosts
127.0.0.1   localhost localhost.localdomain localhost4 localhost4.localdomain4
::1         localhost localhost.localdomain localhost6 localhost6.localdomain6
192.168.139.31 hd1
192.168.139.32 hd2
192.168.139.33 hd3
192.168.139.34 hd4
192.168.139.35 hd5
192.168.139.36 hd6
3)关闭防火墙及Selinux
六台都要做,我这里演示一台
[root@hd1 ~]# systemctl stop firewalld
[root@hd1 ~]# systemctl disable firewalld
[root@hd1 ~]# sed -ri 's/SELINUX=enforcing/SELINUX=disabled/' /etc/selinux/config
4)SSH免密登录
[root@hd1 ~]# ssh-keygen -t rsa -f /root/.ssh/id_rsa -N ''
[root@hd1 .ssh]# cd /root/.ssh/
[root@hd1 .ssh]# rm -f known_hosts
[root@hd1 .ssh]# cp id_rsa.pub authorized_keys
[root@hd1 .ssh]# for i in hd{2..6} ;do scp -r /root/.ssh $i:/root/ ; done
5)部署JDK
[root@hd1 ~]# cd /usr/local/src/
[root@hd1 src]# tar xf jdk-8u221-linux-x64.tar.gz
[root@hd1 src]# mv jdk1.8.0_221 /usr/local/jdk
[root@hd1 src]# for i in hd{2..6} ;do scp -r /usr/local/jdk $i:/usr/local ; done
[root@hd1 src]# vim /etc/profile
.......
export JAVA_HOME=/usr/local/jdk
export PATH=${JAVA_HOME}/bin:$PATH
[root@hd1 src]# source /etc/profile
[root@hd1 src]# java -version
java version "1.8.0_221"
Java(TM) SE Runtime Environment (build 1.8.0_221-b11)
Java HotSpot(TM) 64-Bit Server VM (build 25.221-b11, mixed mode)
[root@hd1 src]# for i in hd{2..6} ;do scp /etc/profile $i:/etc/profile ; done
`分别source剩下主机`
source /etc/profile
6)zookeeper部署
-
ZooKeeper 是为分布式应用程序提供高性能协调服务的工具集合,译名为“动物园管理员”。
-
分布式应用程序可以基于它实现配置维护、命名服务、分布式同步、组服务等。
-
是 Hadoop集群管理的一个必不可少的模块,它主要用来解决分布式应用中经常遇到的数据管理问题,如集群管理、统一命名服务、分布式配置管理、分布式消息队列、分布式锁、分布式协调等。
-
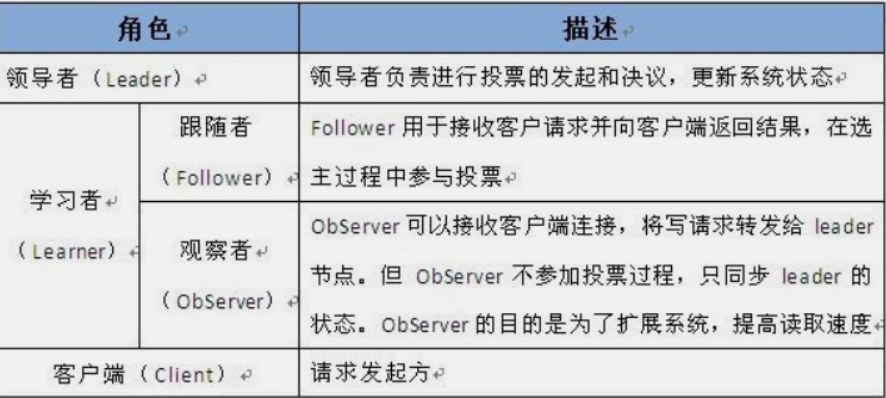
在ZooKeeper集群当中,集群中的服务器角色有两种Leader和Learner,Learner角色又分为Observer和Follower
-
Zookeeper的核心是原子广播,这个机制保证了各个Server之间的同步。实现这个机制的协议叫做Zab协议。Zab协议有两种模式,它们分别是恢复模式(选主)和广播模式(同步)。
-
当服务启动或者在领导者崩溃后,Zab就进入了恢复模式,当领导者被选举出来,且大多数Follower完成了和leader的状态同步以后,恢复模式就结束了。状态同步保证了leader和Follower具有相同的系统状态。
如下图所示:
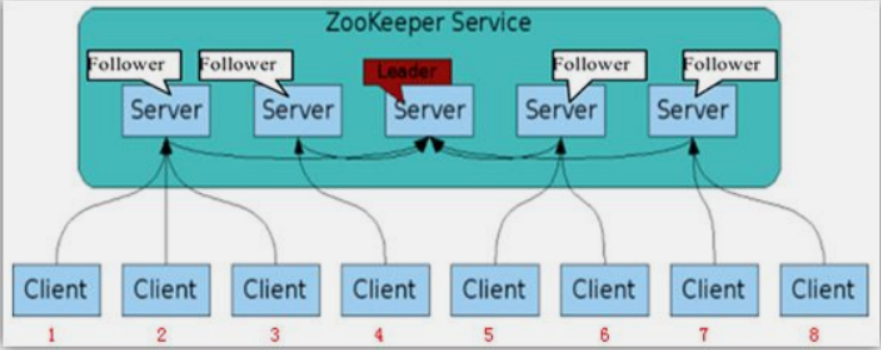
Leader主要有三个功能
-
恢复数据;
-
维持与Learner的心跳,接收Learner请求并判断Learner的请求消息类型;
-
Learner的消息类型主要有PING消息、REQUEST消息、ACK消息、REVALIDATE消息,根据不同的消息类型,进行不同的处理。
Follower主要有四个功能
-
向Leader发送请求(PING消息、REQUEST消息、ACK消息、REVALIDATE消息);
-
接收Leader消息并进行处理;
-
接收Client的请求,如果为写请求,发送给Leader进行投票;
-
返回Client结果。
6.1)获取软件包
https://downloads.apache.org/zookeeper/
6.2)部署软件包
在hd4~6部署zk
[root@hd4 ~]# mkdir /apps/
[root@hd4 ~]# tar xf apache-zookeeper-3.6.4-bin.tar.gz
[root@hd4 ~]# mv apache-zookeeper-3.6.4-bin /apps/zookeeper
[root@hd4 ~]# cd /apps/zookeeper/conf/
[root@hd4 conf]# cp zoo_sample.cfg zoo.cfg
[root@hd4 conf]# grep ^[a-Z] zoo.cfg
tickTime=2000
initLimit=10
syncLimit=5
dataDir=/data/zookeeper
clientPort=2181
maxClientCnxns=120
server.1=192.168.139.34:2888:3888
server.2=192.168.139.35:2888:3888
server.3=192.168.139.36:2888:3888
# 每台服务器myid不同,需要分别修改,例如server.1对应的myid内容为1,server.2对应的myid内容为2,server.3对应的myid为3。
# 2888端口:follower连接到leader机器的端口
# 3888端口:leader选举端口
[root@hd4 conf]# mkdir /data/zookeeper/ -p
[root@hd4 conf]# echo 1 >/data/zookeeper/myid
[root@hd5 ~]# mkdir /apps/
[root@hd5 ~]# mkdir /data/zookeeper/ -p
[root@hd5 ~]# echo 2 >/data/zookeeper/myid
[root@hd6 ~]# mkdir /apps/
[root@hd6 ~]# mkdir /data/zookeeper/ -p
[root@hd6 ~]# echo 3 >/data/zookeeper/myid
[root@hd4 ~]# for i in hd5 hd6 ;do scp -r /apps/zookeeper $i:/apps/ ; done
6.3)添加环境变量
[root@hd4 ~]# vim /etc/profile
export JAVA_HOME=/usr/local/jdk
export ZK_HOME=/apps/zookeeper/
export PATH=${JAVA_HOME}/bin:${ZK_HOME}/bin:$PATH
[root@hd4 ~]# source /etc/profile
[root@hd4 ~]# for i in hd5 hd6 ;do scp /etc/profile $i:/etc/profile ;done
`分别source hd5,hd6主机`
source /etc/profile
6.4)验证zookeeper
三台主机启动zk
[root@hd4 ~]# zkServer.sh start
[root@hd5 ~]# zkServer.sh start
[root@hd6 ~]# zkServer.sh start
[root@hd4 ~]# zkServer.sh status
[root@hd5 ~]# zkServer.sh status
[root@hd6 ~]# zkServer.sh status
7)hadoop软件包获取
[root@hd1 src]# wget --no-check-certificate https://mirrors.tuna.tsinghua.edu.cn/apache/hadoop/common/hadoop-2.10.2/hadoop-2.10.2.tar.gz
[root@hd1 src]# tar xf hadoop-2.10.2.tar.gz
[root@hd1 src]# mv hadoop-2.10.2 /apps/hadoop2102
`配置环境变量,6台都要修改,我只演示一个`
[root@hd1 src]# vim /etc/profile
export JAVA_HOME=/usr/local/jdk
export HADOOP_HOME=/apps/hadoop2102/
export PATH=${JAVA_HOME}/bin:${HADOOP_HOME}/bin:${HADOOP_HOME}/sbin:$PATH
8)完全分布式(HA)配置文件修改
修改hadoop-env.sh 25行,mapred-env.sh 16行,yarn-env.sh 23行
[root@hd1 src]# vim ${HADOOP_HOME}/etc/hadoop/hadoop-env.sh
export JAVA_HOME=/usr/local/jdk
[root@hd1 src]# vim ${HADOOP_HOME}/etc/hadoop/mapred-env.sh
export JAVA_HOME=/usr/local/jdk
[root@hd1 src]# vim ${HADOOP_HOME}/etc/hadoop/yarn-env.sh
export JAVA_HOME=/usr/local/jdk
8.2)core-site.xml
[root@hd1 hadoop]# cd /apps/hadoop2102/etc/hadoop/
<configuration>
<!-- 指定hdfs的nameservice为ns1 -->
  <property>
    <name>fs.defaultFS</name>
    <value>hdfs://ns1</value>
  </property>
<!-- 指定hadoop临时目录 -->
  <property>
    <name>hadoop.tmp.dir</name>
    <value>/data/hadoop/tmp</value>
  </property>
<!-- 指定zookeeper地址 -->
  <property>
    <name>ha.zookeeper.quorum</name>
    <value>hd4:2181,hd5:2181,hd6:2181</value>
  </property>
</configuration>
8.3)hdfs-site.xml
[root@hd1 hadoop]# vim hdfs-site.xml
<configuration>
<!--指定hdfs的nameservice为ns1,需要和core-site.xml中的保持一致 -->
  <property>
    <name>dfs.nameservices</name>
    <value>ns1</value>
  </property>
<!-- ns1下面有两个NameNode,分别是nn1,nn2 -->
  <property>
    <name>dfs.ha.namenodes.ns1</name>
    <value>nn1,nn2</value>
  </property>
<!-- nn1的RPC通信地址 -->
  <property>
    <name>dfs.namenode.rpc-address.ns1.nn1</name>
    <value>hd1:9000</value>
  </property>
<!-- nn1的http通信地址 -->
  <property>
    <name>dfs.namenode.http-address.ns1.nn1</name>
    <value>hd1:50070</value>
  </property>
<!-- nn2的RPC通信地址 -->
  <property>
    <name>dfs.namenode.rpc-address.ns1.nn2</name>
    <value>hd2:9000</value>
  </property>
<!-- nn2的http通信地址 -->
  <property>
    <name>dfs.namenode.http-address.ns1.nn2</name>
    <value>hd2:50070</value>
  </property>
<!-- 指定NameNode的元数据在JournalNode上的存放位置 -->
  <property>
    <name>dfs.namenode.shared.edits.dir</name>
    <value>qjournal://hd4:8485;hd5:8485;hd6:8485/ns1</value>
  </property>
<!-- 指定JournalNode在本地磁盘存放数据的位置 -->
  <property>
    <name>dfs.journalnode.edits.dir</name>
    <value>/data/journal</value>
  </property>
<!-- 开启NameNode失败自动切换 -->
  <property>
    <name>dfs.ha.automatic-failover.enabled</name>
    <value>true</value>
  </property>
<!-- 配置失败自动切换实现方式 -->
  <property>
    <name>dfs.client.failover.proxy.provider.ns1</name>
    <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
  </property>
<!-- 配置隔离机制 -->
  <property>
    <name>dfs.ha.fencing.methods</name>
    <value>sshfence</value>
  </property>
<!-- 使用隔离机制时需要ssh免登陆 -->
  <property>
    <name>dfs.ha.fencing.ssh.private-key-files</name>
    <value>/root/.ssh/id_rsa</value>
  </property>
</configuration>
8.4)配置datanode节点记录文件 slaves
[root@hd1 hadoop]# cat slaves
hd4
hd5
hd6
8.5)mapred-site.xml
[root@hd1 hadoop]# cp mapred-site.xml.template mapred-site.xml
[root@hd1 hadoop]# vim mapred-site.xml
<configuration>
<!-- 指定mr框架为yarn方式 -->
  <property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
  </property>
</configuration>
8.6)yarn-site.xml
[root@hd1 hadoop]# vim yarn-site.xml
<configuration>
<!-- 指定resourcemanager地址 -->
   <property>
     <name>yarn.resourcemanager.hostname</name>
     <value>hd3</value>
   </property>
<!-- 指定nodemanager启动时加载server的方式为shuffle server -->
  <property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
  </property>
</configuration>
9)复制修改后的hadoop目录到所有集群节点
[root@hd1 hadoop]# for i in hd{2..6} ;do scp -r /apps/hadoop2102 $i:/apps/ ; done
`source六台服务器`
source /etc/profile
10)在datanode节点(3台)启动zookeeper
# 因为我前面已经启动的这里查看一下状态即可 如果没有启动
[root@hd4 apps]# zkServer.sh status
#如果没有启动执行
zkServer.sh start
11)启动journalnode(在namenode上操作,例如hd1)
[root@hd1 hadoop]# hadoop-daemons.sh start journalnode
hd6: starting journalnode, logging to /apps/hadoop2102/logs/hadoop-root-journalnode-hd6.out
hd5: starting journalnode, logging to /apps/hadoop2102/logs/hadoop-root-journalnode-hd5.out
hd4: starting journalnode, logging to /apps/hadoop2102/logs/hadoop-root-journalnode-hd4.out
分别到hd4、hd5、hd6节点上进行验证
[root@hd4 apps]# jps
3209 JournalNode
2766 QuorumPeerMain
3263 Jps
12)格式化hdfs文件系统(在namenode上操作,例如hd1)
[root@hd1 hadoop]# hdfs namenode -format
`格式化完成后,请把/data/hadoop/tmp目录拷贝至hd2相应的位置,hd2将不再需要格式化,可以直接使用。`
[root@hd1 hadoop]# scp -r /data/hadoop hd2:/data
13)格式化zk(namenode上操作,例如hd1)
[root@hd1 hadoop]# hdfs zkfc -formatZK
14)启动hdfs(namenode上操作,例如hd1)
[root@hd1 hadoop]# start-dfs.sh
`检查状态`
"hd1和hd2"
[root@hd1 hadoop]# jps
14115 Jps
13734 NameNode
14038 DFSZKFailoverController
"hd4~hd6"
[root@hd4 apps]# jps
3209 JournalNode
3417 Jps
3309 DataNode
2766 QuorumPeerMain
15)启动yarn(namenode上操作,例如想让hd2成为resourcemanager,需要在hd2上启动。)
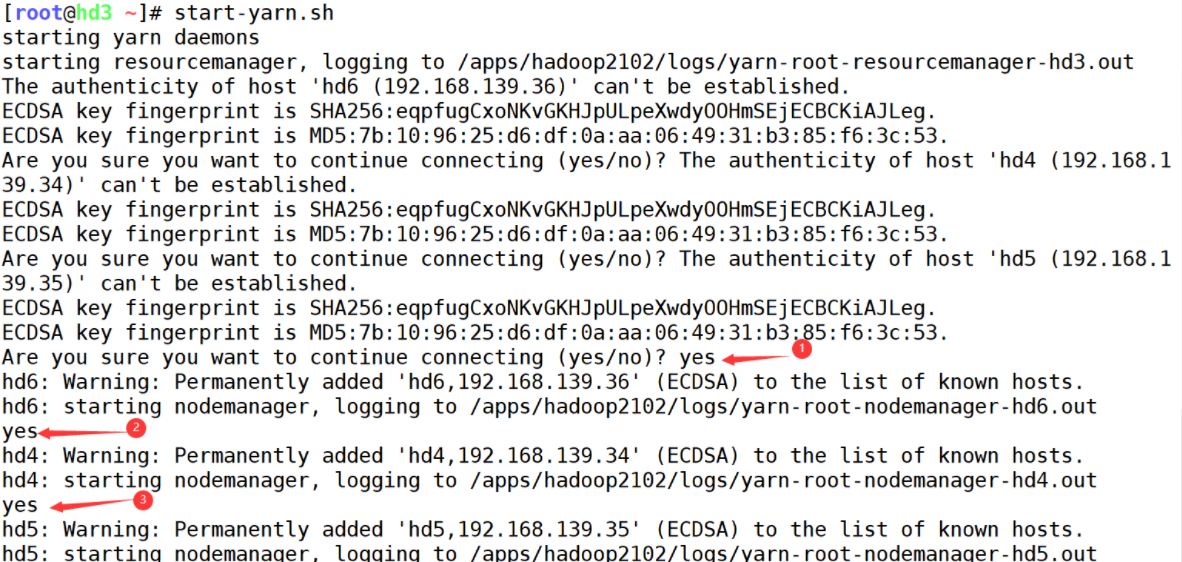
[root@hd3 ~]# start-yarn.sh
#主要这里要输入三个yes,这个是因为ssh第一次连接导致的
`验证码服务`
"hd1和hd2"
[root@hd1 hadoop]# jps
14115 Jps
13734 NameNode
14038 DFSZKFailoverController
"hd3"
[root@hd3 ~]# jps
13512 Jps
13244 ResourceManager
"hd4~hd6"
[root@hd4 apps]# jps
3460 NodeManager
3209 JournalNode
3577 Jps
3309 DataNode
2766 QuorumPeerMain
16)访问
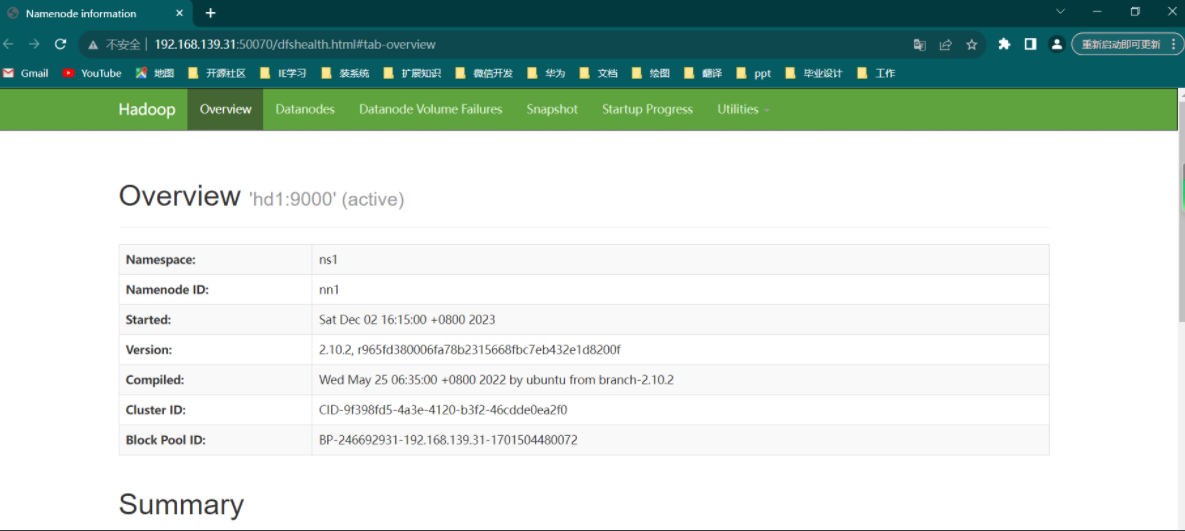
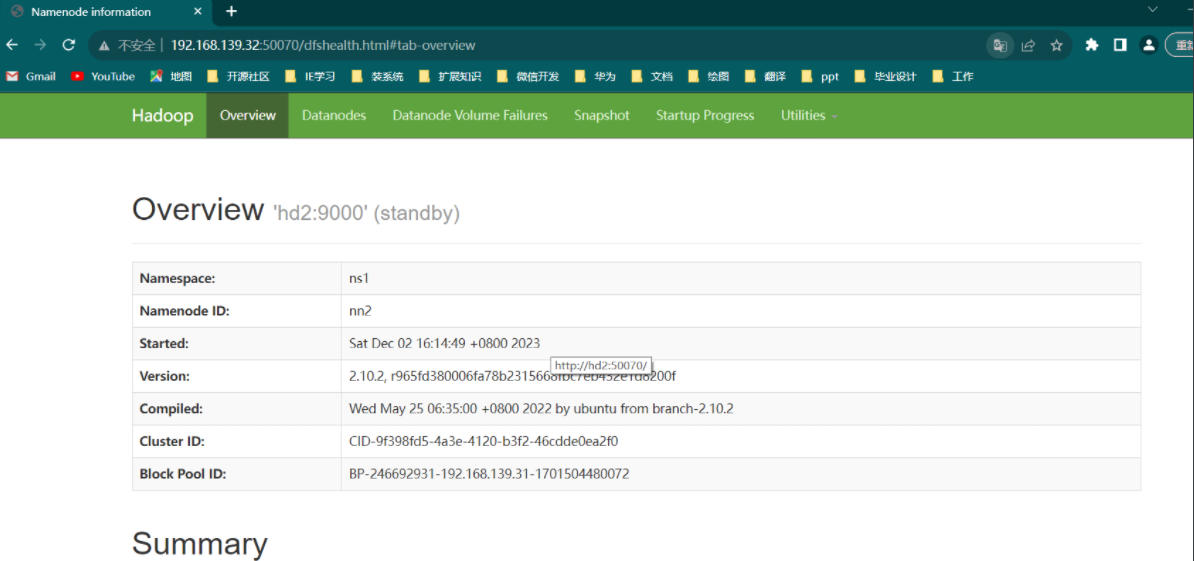
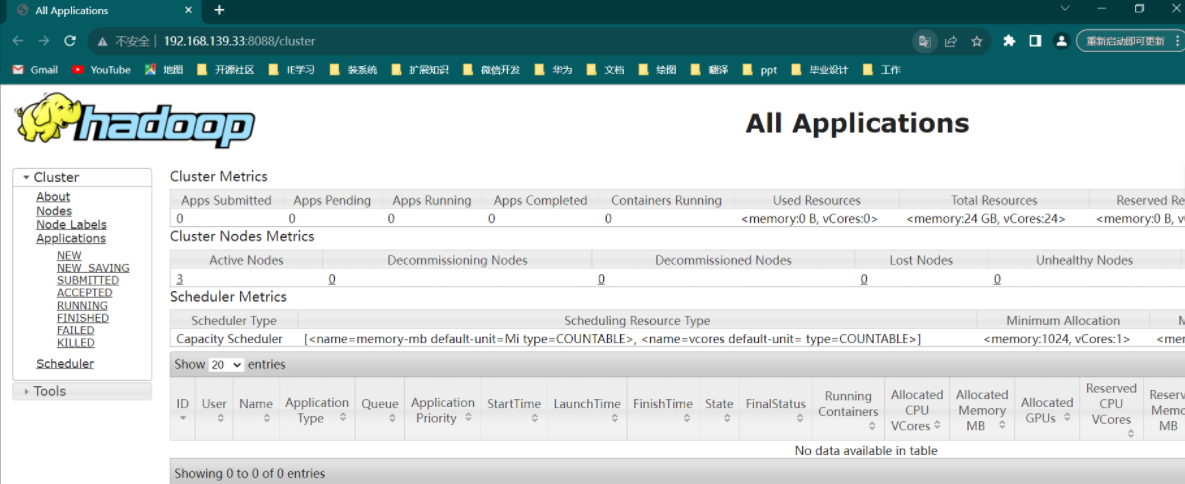
17)测试MapReduce
`创建目录`
[root@hd1 ~]# hdfs dfs -mkdir /input
`准备文件`
[root@hd1 ~]# vim test.txt
nihap
12333
123332
12333
192.168.139.33
192.168.139.33
192.168.139.31
nihap
`上传文件`
[root@hd1 ~]# hdfs dfs -put /root/test.txt /input
`运行实例`
[root@hd1 ~]# yarn jar /apps/hadoop2102/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.10.2.jar wordcount /input /output/00
`查看输出结果`
[root@hd1 ~]# hdfs dfs -ls /output/00
Found 2 items
-rw-r--r--   3 root supergroup          0 2023-12-02 16:35 /output/00/_SUCCESS
-rw-r--r--   3 root supergroup         59 2023-12-02 16:35 /output/00/part-r-00000
[root@hd1 ~]# hdfs dfs -cat /output/00/part-r-00000
12333   2
123332  1
192.168.139.31  1
192.168.139.33  2
nihap   2

文章评论